Scrape the Shit!
10. Oktober 2026
Tags: Technik, Digitales
Lesezeit: 15 Minuten
Manchmal fällt es mir doch schwer, geeignete Überschriften für meine Blogeinträge zu finden. Geeignet, also krass reißerisch, mit tendenziösen Implikationen. Alle wollen klicken und können gar nicht mehr den Inhalt erwarten. Das will ich! Nee, nicht wirklich. Aber als Inspiration für witzige Überschriften könnte ich manchmal eine kleine Unterstützung gebrauchen.
Ich habe bereits öfter über meine Verwendung der großen KI Modelle geschrieben. Ganz leicht könnten mir Gemini, Claude und Co. bei den Überschriften helfen. Aber dieses Mal will ich das Zepter selbst in der Hand behalten und beginne eine neue Blogserie, in der ich beschreibe, wie ich mir meine eigene Überschriften-KI from scratch programmiere. Den Shitifier!
Forschung
Es ist relativ einfach zu finden, dass ich bereits mehrere Paper und Vorträge zum Einsatz von neuronalen Netzen veröffentlicht habe. Für Alle, die es interessiert ein kurzer Auszug:
- https://www.sciencedirect.com/science/article/pii/S2666352X26000981
- https://www.sciencedirect.com/science/article/pii/S2666352X25000275
Die meiner Meinung nach wichtigste Einschränkung dieser Ansätze ist die feste Anzahl der Input-Neuronen. Ein Beispiel zeigt das erste Paper (open access): Das neuronale Netz ist darauf trainiert, genau die Ausgabe dieses einen Spektrometers zu verarbeiten. Soll ein Spektrometer mit anderer Auflösung verwendet werden, muss das Netz neu trainiert werden. Genau da liegt das Problem: Beim Wechsel der Hardware wird das Netz unbrauchbar, obwohl die für uns wichtige Information ja eigentlich weiterhin in den Gewichten der Neuronen codiert ist.
Diese Artikelserie ist mein erster Versuch, diese Einschränkung zu umgehen, und zwar mit Netzen, die variable Kontextlängen akzeptieren. Transformer können genau das. Sie wurden zwar für Texte entwickelt, aber Text ist »nur« eine Abfolge von Zeichen, die einer Systematik folgen. Ein Licht-Spektrum ist letztlich auch eine Folge von Messwerten, also Zeichen, die einer Systematik folgen. Diese Systematik ist zwar anders als die von Texten, aber sie ist eine.
Da ich nicht einfach ein paar hundert oder tausend Zeilen Code schreiben kann und alles funktioniert sofort, brauche ich ein Übungsobjekt, an dem ich Möglichkeiten und Grenzen dieser Netzwerktopologie abschätzen kann. Schlagzeilen eignen sich dafür gut: Sie sind kurz, in wirklich großer Menge (100k bis 1M, und das wären erst zwei Quellen) verfügbar, und den Lernerfolg des Modell sieht man sofort: kommt Müll raus, dann ist was schiefgegangen.
Das ist der Zweck dieser Themenserie: Ich will verstehen, wie Transformer-Netzwerke funktionieren und wie ich sie in der wissenschaftlichen Forschung einsetzen kann.
Reg den Shit auf Ex!
Daten sind zum trainieren die wichtigste Grundlage. Ab jetzt werde ich die Trainingsüberschriften nur noch Shit nennen, denn das ist es, was wir im Endeffekt produzieren werden. Shit rein, Shit raus! Woher bekommen wir den Überschriftenshit? Natürlich vom größten Shitproduzenten Deutschlands. Ich sag nicht wer oder was; das soll eurer eigenen Phantasie überlassen bleiben. Das Beste ist, der Shitschatz lässt sich einfach direkt über das Internetz heben und wartet mit dem besten Shitarchiv von über 20 Jahren auf uns.
AUFGEPASST! Ab hier kann sich jeder ausmalen, welche Zeitung ich meine. Ich hätte allzu gerne deren Überschriften verwendet, aber mich dagegen entschieden. Mehr dazu im Abschnitt „Geschulte Person in der Umgehung des Gesetzes“
Um elaboriert Schätze zu heben, benötigen wir Rüstzeug. Der Einstieg ins Web-scrapen geht eigentlich immer über die sogenannten regulären Ausdrücke oder im Fachjargon (Englisch) regular expressions, kurz RegExp. In den meisten Programmiersprachen lautet der Befehl dann auch einfach regexp. Damit kann man sehr einfach gesagt Zeichenketten nach definierbaren Eigenschaften durchsuchen, teilen, ersetzen ...
Für das Training des Shitifiers, benötige ich eigentlich nur die Überschriften. Ich speichere aber trotzdem noch weitere Informationen, entweder um Dopplungen zu filtern oder um neue Funktionen anzutrainieren:
- Titelzeile
- Dachzeile oder Teaser
- Kategorie
- Datum
- Link
Diese Informationen müssen sicher im HTML Code gefunden werden. Das ist eine Möglichkeit, wie die Daten einer einzelnen Überschrift im Hintergrund vorliegen. Die Formatierung wird durch den Browser gerendert und mittels CSS definiert.
Beispiel 1:
  ...
  Vorhergehender Artikel
<article>
  <a href="der-link-zum-artikel">
    <div class="zeit">
      <time datetime="2024-09-26T16:42:22">16:42 Uhr</time>
    </div>
    <div class="inhalt">
      <span class="kategorie">KI Modelle</span>
      <span class="dachzeile">Hier wird programmiert</span>
      <span class="ueberschrift">Scrape the Shit</span>
    </div>
  </a>
</article>
  Nächster Artikel
  ...
Beispiel 2:
  ...
  Vorhergehender Artikel
<div class="breaking-news">
  <div class="content">Eilmeldung</div>
</div>
<div class="top-news">
  <div class="content">Topmeldung</div>
</div>

<div class="row-wrapper">
  <div class="fields-wrapper">
    <div class="kategorie">Statistik</div>
    <H2 class="title">Raser am Steuer</H2>
    <div class="date-time">
      <time datetime="2018-09-04T11:39:27+02:00">04. September 2018 | 11:39</time> Uhr
    </div>
    <div class="teaser">Rote Ampeln bremsen ihn nicht!</div>
    <div class="ort">Bröselwitz</div>
    <div class="banner">
      <span>Hinweise!</span>
    </div>
  </div>
</div>
  Nächster Artikel
  ...
Die Informationen stehen also geordnet zwischen den HTML-Elementen <article>, <div>, <span>, <a> oder<time>. Die Beispiele oben sind von mir schön gemacht. Ich habe Zeilenumbrüche und Einrückungen eingefügt. Im Original ist das einfach eine Zeile. Der Browser achtet beim rendern nicht auf solchen Schnickschnack. Da müssen die HTML-Elemente nur richtig geöffnet und geschlossen werden.
Zeichen
HTML-Elemente bestehen immer aus einem Wort und möglicherweise einer Zahl, ohne Freizeichen: a bis z, A bis Z und 0 bis 9. Diese kann man zu einer Zeichenklasse mit [ ] zusammenfassen. Wir suchen also nach etwas, was [a-zA-Z0-9_] entspricht und das ist die vordefinierten Zeichenklasse der „Wortzeichen“ \w.
Für Deutschsprechende: aufpassen! Hierbei werden Umlaute und ß nicht in jeder Programmierungsumsetzung erkannt!
Eine weitere wichtige Zeichenklasse ist . Diese fasst alle Zeichen außer den Zeilenumbruch.
Für uns nicht wichtig: \d für alle Zahlen und \s für alle whitespaces (Leerzeichen und Steuerzeichen)
Mit <\w+> als Suchschema würden wir in dem Beispiel oben nur ein Mal <article> und ein Mal <div> finden.
Ein weiteres für uns sehr wichtiges Zeichen ist das Nicht-Zeichen ^. Dieses invertiert alles in den Eckigen Klammern. Mit [^1] finden wir alle Zeichen, außer der 1.
Zählen
Bei Regexp kann man Zeichen und Zeichengruppen zählen lassen. Das geht mit geschwungenen Klammer und definierten Zeichen
{x}: genau x Mal{x,y}: x bis y Mal, wenn y beliebig sein soll, dann lässt man es einfach weg*: keinmal oder öfter → {0,}+: mindestens ein Mal → {1,}?: kein oder ein Mal → {0,1}
Wenn wir div, a und article finden wollen, dann könnten wir also nach <\w+>.*</\w+>, suchen, da:
- mindestens ein Buchstabe in einem HTML-Element vorkommen muss,
- kein Freizeichen in HTML-Elementen vorhanden ist,
- HTML-Elemente werden mit
/geschlossen und - zwischen den
<ELEMENT>und</ELEMENT>steht oft die gewünschte Information.
Die Ausgabe gibt einfach das gesamte Beispiel als Antwort zurück:
- mit
<\w+>findet regex das<article> - die Kombination
.*findet jedes Zeichen bis zum Ende des Beispiels. - Dann merkt regex, dass die Zeichenkette vorbei ist und läuft rückwärts, bis es das
</\w+>findet.
So wollen wir das nicht.
Gruppierungen und Token
In Regexp sind Gruppierungen und Tokens möglich. Um diese zu erzeugen werden ganz lapidar runden Klammern ( ) um den Ausdruck gesetzt. Alles was in runden Klammern steht ist Gruppiert und wird zur weiteren Verwendung als Token gespeichert. Referenzen ruft man mit z.B. \1 auf, wobei die 1 hier für die Nummer der Gruppierung im regulären Ausdruck steht. Für uns heißt das: wir gruppieren \w+ und verwenden die Referenz \1um dasselbe Tag beim schließen zu finden.
Es passiert das selbe, wie oben, außer dass regex uns nun sagt, dass er den Token article gefunden hat.
Gierige Quantoren
Durch die regex-Suche mit .*, also möglichst viele Zeichen, finden wir immer die längste Zeichenfolge, die unseren Kriterien entspricht.
Mit <div[^>]*>.*</div> finden wir im obigen Beispiel die Zeichenkette von direkt zwei div-Elementen. Die Kombination .* wird als gierig bezeichnet.
Damit wir beide div-Elemente finden, können wir den Quantor faul machen, indem wir ein Fragezeichen anhängen. Dann gibt regex mit <div[^>]*>.*?</div> die zwei Elemente als getrenntes Ergebnis aus.
Genauer Blick auf die Struktur von Beispiel 1
Wie könnte es funktionieren bei einem Archiv mit ca. 1 Mio Überschriften.
- Ich teile die unterschiedlichen Überschriften mit
<article[^>]*>(.*?)</article>. Damit finde ich denarticle-Tag, auch wenn noch zusätzliche Informationen, wie ID oder styling Informationen vermerkt sind.(.*?)ist faul und gibt mir die Zeichen, die zwischen dem Start- und dem nächsten End-Element stehen als Token aus. Damit habe ich die einzelnen Überschriftenblöcke getrennt. - Den Link finde ich mit
<a href="([^"]*)"[^>]*>. Alles was in den Anführungszeichen steht ist die für mich interessante Information. - Die Zeit finde ich mit
<time[^>]+datetime="([^"]*)[^>]*>. Auch hier steht die Zeit in den Anführungsstrichen. - Dachzeile und Überschrift finde ich gleichzeitig mit
<span[^>]+class="([^"]*)"[^>]*>([^<]*)</span>. So werden direkt zwei Token ausgegeben, die Art (Dachzeile oder Überschrift) und der dazugehörige Text.
Fertig!
Geschulte Person in der Umgehung des Gesetzes
Um mit jenen Personen kein zu intimes Gespräch führen zu müssen, habe ich mich gegen die Zeitung entschieden. Die Verwendung jeglicher KI auf deren Daten wird explizit ausgeschlossen. Deren »Regeln« lassen da keinen Raum für Interpretationen. Es ist trotzdem schon tragisch, dass die Zeitung, die auf jegliche Privatsphäre scheißt, so pingelig die Nutzung durch KI verbietet.
Welche Regeln und Gesetze muss man denn dann einhalten?
§44b UrhG - Text und Data Mining
(1) Text und Data Mining ist die automatisierte Analyse von einzelnen oder mehreren digitalen oder digitalisierten Werken, um daraus Informationen insbesondere über Muster, Trends und Korrelationen zu gewinnen.
(2) Zulässig sind Vervielfältigungen von rechtmäßig zugänglichen Werken für das Text und Data Mining. Die Vervielfältigungen sind zu löschen, wenn sie für das Text und Data Mining nicht mehr erforderlich sind.
(3) Nutzungen nach Absatz 2 Satz 1 sind nur zulässig, wenn der Rechtsinhaber sich diese nicht vorbehalten hat. Ein Nutzungsvorbehalt bei online zugänglichen Werken ist nur dann wirksam, wenn er in maschinenlesbarer Form erfolgt.
Abs. 3 Satz 2 sagt ja bereits alles aus: wir dürfen Text und Data Minen, wenn der Rechtsinhaber dieses nicht maschinenlesbar ausgeschlossen hat.
§60c UrhG - Wissenschaftliche Forschung
(1) Zum Zweck der nicht kommerziellen wissenschaftlichen Forschung dürfen bis zu 15 Prozent eines Werkes vervielfältigt, verbreitet und öffentlich zugänglich gemacht werden 1. für einen bestimmt abgegrenzten Kreis von Personen für deren eigene wissenschaftliche Forschung
(2) Für die eigene wissenschaftliche Forschung dürfen bis zu 75 Prozent eines Werkes vervielfältigt werden.
§60d UrhG - Text und Data Mining
(1) Vervielfältigungen für Text und Data Mining (§ 44b Absatz 1 und 2 Satz 1) sind für Zwecke der wissenschaftlichen Forschung nach Maßgabe der nachfolgenden Bestimmungen zulässig.
(3) Zu Vervielfältigungen berechtigt sind ferner 2. einzelne Forscher, sofern sie nicht kommerzielle Zwecke verfolgen.
§87c UrhG - Schranken des Rechts des Datenbankherstellers
Aus §87a UrhG: Eine Datenbank im Sinne dieses Gesetzes ist eine Sammlung von Werken, Daten oder anderen unabhängigen Elementen, die systematisch oder methodisch angeordnet und einzeln mit Hilfe elektronischer Mittel oder auf andere Weise zugänglich sind und deren Beschaffung, Überprüfung oder Darstellung eine nach Art oder Umfang wesentliche Investition erfordert.
Die Vervielfältigung eines nach Art oder Umfang wesentlichen Teils einer Datenbank ist zulässig
(2) zu Zwecken der wissenschaftlichen Forschung gemäß § 60c,
(3) zu Zwecken des Text und Data Mining gemäß § 44b,
(5) zu Zwecken des Text und Data Mining für Zwecke der wissenschaftlichen Forschung gemäß § 60d.
DSGVO
Namen, Initialen, Alter oder Wohnort in Zusammenhang zu einer Straftat sind personenbezogene Daten. Für mich bedeutet das, dass ich Pseudonymisieren und die Ortsnamen ersetzen werde.
Da lasse ich mir noch was Witziges einfallen.
AGBs, Impressums, technische Sperren
Der für mich relevante Fall der Daten der Polizei NRW: „Der Nachdruck und die Auswertung von Pressemitteilungen mit Quellenangabe ist gestattet. Hierzu sind folgende Angaben auszuweisen: Jahreszahl, IM NRW“
robots.txt
In der robots.txt legt der Betreiber einer Website fest, welche Zugriffe erlaubt und welche nicht erlaubt sein sollen. Wer Shit abgreifen will, schaut vorher rein, um nachher nicht selbst voller Scheiße zu sein.
Der Shitproduzent meiner eigentlichen Wahl hat hier saubere Arbeit geleistet: Seine robots.txt schließt rund achtzig KI-Crawler namentlich aus. Noch vor der ersten Sperre, in der ersten Zeile, wird auf eine Lizenzdatei verwiesen.
Darum bin ich ausgewichen auf Polizeimeldungen aus NRW. Deren robots.txt enthält:
- keinen Vorbehalt gegen KI oder Text- und Data-Mining,
- keine Sperren für bestimmte Crawler wie GPTBot oder CCBot und
- keinen
Crawl-delay. Ich lade ca. eine Seite pro Sekunde.
RSL
RSL ist eine maschinenlesbare XML Datei, mit der die robots.txt mit Lizenzbedingungen erweitert werden kann. Denn §44b UrhG erlaubt prinzipiell Text- und Data-Mining, außer §44b Abs. 3: ein Nutzungsvorbehalt bei online zugänglichen Werken ist nur dann wirksam, wenn er in maschinenlesbarer Form erfolgt. Und genau dafür ist RSL gebaut. In diesem Fall wird dort geregelt, ob die Inhalte für KI-Training genutzt werden dürfen.
<rsl>
  <content url="/">
    <license>
      <prohibits type="usage">ai-train ai-input</prohibits>
    </license>
  </content>
</rsl>
Es ist also nicht nur nicht erlaubt deren Daten als KI-Trainingsdaten zu verwenden, man darf diese noch nicht mal mit einer KI verwenden.
Technisch könnte ich trotzdem einfach darauf zugreifen. Weder robots.txt noch RSL sperren mich hier aus. Auch §60d UrhG lässt meines Verständnisses nach eine Nutzung der Daten zu. Dennoch achte ich deren Wünsche, ich bin ja kein Frevler, der anderleuts Begehren missachtet. Ich bin eine geschulte Person in der Einhaltung der Netiquette und verwende die Daten, die nach meinem jetzigen Verständnis für mich rechtmäßig verfügbar sind, aber ich bin noch lange kein Jurist.
Meine Angaben
- Ich verwende die Überschriften, die Kurzzusammenfassung, das Datum und die Kategorie der Pressemitteilungen der Polizei NRW: 2015 bis 2026, IM NRW.
- Die Daten werden nicht-kommerziell verwendet um zu untersuchen, wie Transformer-Netzwerken funktionieren und sich in der wissenschaftliche Forschung einsetzen lassen.
- Bilder und Downloads werden nicht verwendet.
- Der Rohdatensatz wird nicht veröffentlicht und nicht weitergegeben.
- Namen und Ortsnamen werden durch Zufallsnamen ersetzt.
- Nach Abschluss des Projektes werden die Daten gelöscht.
- Ausgaben des Modells werden eindeutig gekennzeichnet.
Daten
Die Daten kommen alle aus dem Meldungsarchiv der polizei.nrw. Die Daten, die ich gesammelt habe stammen aus dem Zeitraum 01.10.2015 bis zum 01.10.2026, also umfassen 11 Jahre. In Summe sind das 115800 Überschriften/Teaser Kombinationen, die zum Trainieren verwendet werden.
Damit nicht so viele Doubletten entstehen, habe ich die Daten mit aufsteigendem Datum sortieren lassen, also von hinten heruntergeladen. Die neueste Meldung ist in diesem Fall auf der letzten Seite. Da es immer mal wieder Probleme mit dem regexpen hatte, habe ich eine Sicherheitskopie auf meiner Festplatte gespeichert, so dass ich die Auswertung auf lokale Daten anwenden konnte. Die Entscheidung war auch sehr gut, da die Verbindung zum Server regelmäßig abgebrochen ist.
| # | Aktion | Dauer | Anzahl |
|---|---|---|---|
| 0 | html einlesen | 1770 s = 30 min | 115794 |
| 1 | leere Texte löschen | 0,05 s | 115292 |
| 2 | Zeilenumbrüche und Sonderzeichen | 30,7 s | |
| 3 | Kurze und lange Texte löschen | 1 s | 114737 |
| 4 | Einzelne Ortsnamen löschen | 1,2 s | 112475 |
| 5 | Zusammengesetzte Ortsnamen löschen | 1,2 s | 109965 |
| 6 | Blacklist-Wörter löschen | 15 s | 104573 |
| 7 | Städte anonymisieren | 1307 s = 20 min | |
| 8 | Was bleibt übrig | per Hand | 103385 |
| 9 | Seltene Zeichen entfernen |
Schritt 0: Das Einlesen der html-Dateien lief im groben mit der oben beschriebenen regexp-Methode. In diesem Schritt werden die Daten nicht verändert, sondern 1-zu-1 in eine sehr große Tabelle mit vier Feldern geschrieben: Datum, Kategorie, Überschrift, Zusammenfassung
Schritt 1 - leere Felder: Das ist selbsterklärend. Ich suche nach "" und nach " ", falls dann doch mal bei Einlesen ein Leerzeichen durchgerutscht ist. Felder die komplett leer sind, also auch keine String-Begrenzung "" enthält, gibt es nicht.
Schritt 2 - Zeilenumbrüche: Damit fing der Scheiß an. Denn ein Zeilenumbruch wird »normalerweise« durch \r\n (#13 und #10 hintereinander) vollzogen. Die äquivalente HTML-Entität Zeilenumbruch lautet <br>. Also sind das noch Überbleibsel aus deren Schreibprogramm, die nicht richtig umgewandelt worden sind.
Können raus, da Überschriften normalerweise keine Umbrüche haben. Davon gibt es 11062! Das ist ein Wert, der mich beunruhigt. Anscheinend habe ich das Zerlegen über regexp nicht richtig gemacht.
Eine Überschrift, die ich dazu schnell finde, ist vom 09 Oktober 2024 um 15:16:58 Uhr, mit:
Stadtname<br />
<br />
Eine Gruppe von Leichtkraftradfahrern geriet am Montagabend in den Fokus der Polizei.
Nachdem ich einige Überschriften kontrolliert habe bin ich mir sicher, dass die Anzahl doch stimmen kann. Aber der Zeilenumbruch ist hier anders codiert.
Ich lösche alle Versionen von <br> und von \r\n ab, da ich keine Lust auf Überraschungen habe.
Schritt 2 - Sonderzeichen: Alles soll korrektes Unicode sein, darum mussten alle html-Entities in Unicode umgewandelt und Umlaute vereinheitlicht werden. Denn Umlaute können verschieden geschrieben werden, entweder als z.B. ä (U+00E4) oder als a mit Trema (U+0061 & U+0324)
Schritt 4 - einzelne Städtenamen: Viele Teaser oder Kicker haben nur ein Wort. Beispielsweise: Köln. Damit kann ich nichts anfangen. Also habe ich aus Wikipedia eine Liste mit allen 396 Gemeinden NRWs zusammengestellt.
Hier wird zuerst geprüft, ob der Kicker/Zusammenfassung nur aus einem Wort besteht, und wenn ja gegen diese Liste mit ismember gecheckt. Jeder Treffer wird gelöscht.
Schritt 5 - Zusammengesetzte Ortsnamen: Das wird noch spannender. Einige Orte werden mit Stadtteil angegeben. Beispielsweise: Köln-Kalk. Das soll auch weg. Also trennen wir die Zusammenfassung am - und schauen nach, ob der erste Teil ein Stadtname ist. Wenn ja, wird der Eintrag gelöscht.
Schritt 6 - Blacklist: Es wird immer mehr. Nun kommen solche merkwürdigen Dinge dran, wie Floskeln (Zeugensuche, Hinweise erbeten, Folgemeldung) und noch weitere Informationsfetzen, die die Datenlage verschlechtern (PLZ: 47289, Kennzeichen, alles in Klammern: (mb) oder (Sa., 13. xxxx) ). Diese wird in einer Textdatei in korrekten regulären Ausdrücken gespeichert und mit regexprep caseinsensitive gelöscht.
Schritt 7 - Städtenamen anonymisieren: Dazu habe ich mit Claude, Gemini, ChatGPT und DeepSeek, jeweils 100 erfunden Städtenamen aus dem Bereich lustig (Dösingen im Halbschlaf), SciFi (Megablock 77), Fantasy (Vogelweide) und asiatisch (Yunjin) erzeugen lassen. Da ein paar Städte nicht aus NRW sind, habe ich noch einige Namen auf beiden Seiten hinzugefügt (Wiffleworth).
Schritt 8: Jetzt schauen wir uns mal an, wie die Kicker mit weniger als zehn Zeichen aussehen. Es sind unter diesen Einschränkung insgesamt 108 unterschiedliche Phrasen übrig. Dabei sind solche Sachen wie: Festnahme, ein einzelnes ! oder ., aber auch Folge #11 und restliche Kennzeichen. Ich entscheide mich alle Zeilen, die hier angezeigt werden, zu löschen.
Außerdem habe ich noch ein paar Zeilen per Hand gelöscht.
Zeichenstatistiken
Nach einem ersten Durchlauf, in dem ich noch nicht alle Überschriften geladen hatte waren es bereits 11.303.276 Zeichen in Überschrift und Teaser kombiniert. Damit kann man schon etwas an nötiger Statistik betreiben. Die Anzahl der verschiedenen Zeichen ist eine wichtige Größe beim Training der Modelle. Ein Ziel ist es seltene Zeichen zu finden um entweder zu eliminieren oder zu ersetzen.
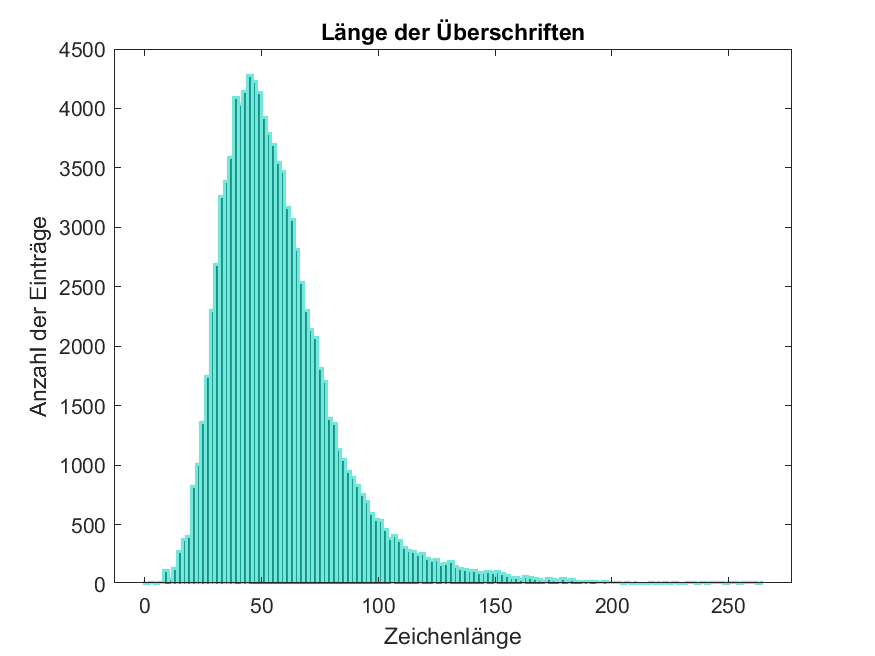
Das Problem bei Histogrammen ist, dass sie stinke langweilig sind. Bitte weitergehen, es gibt hier nichts zu sehen! Die Überschriften sind halt irgendwie unsymmetrisch um die Zeichenlänge von 50 verteilt und zeigen einen längeren Ausläufer bis ca. 250 Zeichen. OK, danke!
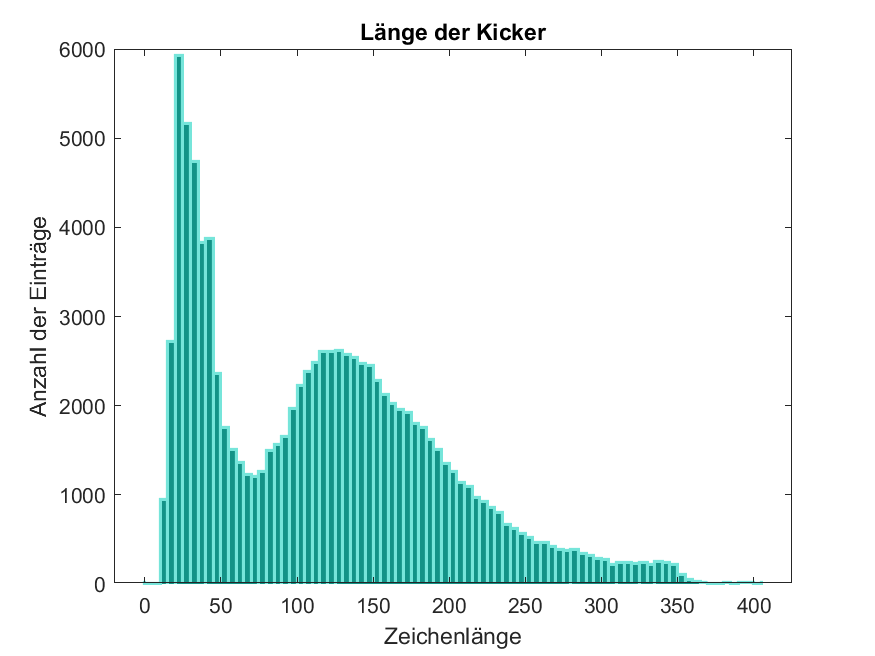
Die Zeichenstatistik vom Kicker zeigt eine deutlich Bimodale Verteilung. Wir könnten jetzt in zwei Stellvertreter dieser Gruppen hineinschauen, das machen wir aber nicht. Das Transformer Netzwerk soll nachher eh beides beherrschen. Wichtig sind diese Größen eh erst, wenn wir das Transformernetz programmieren und die Tokenanzahl festlegen. Hier ist es nur ein Bild mehr.
Wenn eine Überschrift von 1000 in chinesischen Zeichen geschrieben ist, dann wird diese Information wenig zum Training beitragen und den nötigen Zeichensatz unnötig aufblähen.
Einige »Bedeutungen« können durch unterschiedliche Zeichen ausgedrückt werden. Zum Beispiel werden oft Bindestriche verwendet. Nehmen wir mal die mögliche Bedeutung eine Minuszeichens heraus, dann wird auch in Texten aus der selben Quelle wild gemixt.
| Zeichen | Name | HTML | Anzahl |
|---|---|---|---|
| - | Minuszeichen | #45 | 74931 |
| ‐ | Viertelgeviertstrich | #8208 | 0 |
| – | Halbgeviertstrich | #8211 | 5458 |
| — | Geviertstrich | #8212 | 0 |
| ⸺ | Doppelgeviertstrich | #11834 | 0 |
Das sind alles Zeichen, die als Bindestrich verwendet werden, ob nun richtig oder falsch, ist hierbei egal. Ein paar meist eingehaltene Regeln gibt es doch; der als Bindestrich gemeinte Bindestrich steht ohne Leerzeichen zwischen zwei Wörtern. Alle anderen Striche haben vorausgehende und folgende Leerzeichen. Beim Geviertstrich muss man jedoch aufpassen, denn wenn er richtig eingesetzt wird, dann ersetzt er den Gedankenstrich, aber dafür ohne vorausgehende und folgende Leerzeichen.
Na gut. Ihr seht, dass es doch komplizierter ist als gedacht. Schauen wir uns erstmal alle Zeichen an, die vorkommen
!"#%&'()*+,-./0123456789;<=>?@ABCDEFGHIJKLMNOPQRSTUVWXYZ[]^_`abcdefghijklmnopqrstuvwxyz| §¬®´½ÄËÖÜßàáâãäçèéêëíñóôöûüğŠ‑–‘’‚“”„…€−─✅und das hier sind die Zeichen, die seltener als zehn Mal vorkommen
!"#%&'()*+;<=>?@[]^_`| §¬®´½ÄËÖÜàáâãçèéêëíñóôûğŠ‑‘’‚“”„…€−─✅dabei sind auch Exoten, wie das Substitutionszeichen #26, von dem ich vorher noch nie gehört habe.
Das sollten 62 Zeichen sein. Ich sehe nur 54. Das bedeutet, dass die restlichen Zeichen Steuerzeichen sind und nicht dargestellt werden.
Schritt 9 - seltene Zeichen: Den Schwellwert wähle ich, dass ca. 99,9% aller Zeichen erhalten bleiben. In diesem Datensatz ist der Schwellwert bei 1300. Also wenn ein Zeichen seltener als 1300 Mal vorkommt könnten sie eigentlich einfach gelöscht werden. Zur Einschätzung: bei 1500 ist bereits das q enthalten also Vorsicht bei der Wahl.
Es gibt noch eine weitere Möglichkeit, die ich hier wähle: zum Beispiel die Zeichen èéêë kommen in allen 100 000 Überschriften zusammen ca. 10 mal vor, also in jeder zehntausendsten Überschrift. Ich denke, dass es kein Problem sein wird diese einfach durch ein e zu ersetzen. Und wenn, dann kann es ja nur mich stören, weil ich diese Daten nicht veröffentlichen werde. So verfahre ich auch mit den andern Zeichen. Die ZeichenÄ#%&§€()*+, behalte ich, obwohl sie selten vorkommen.
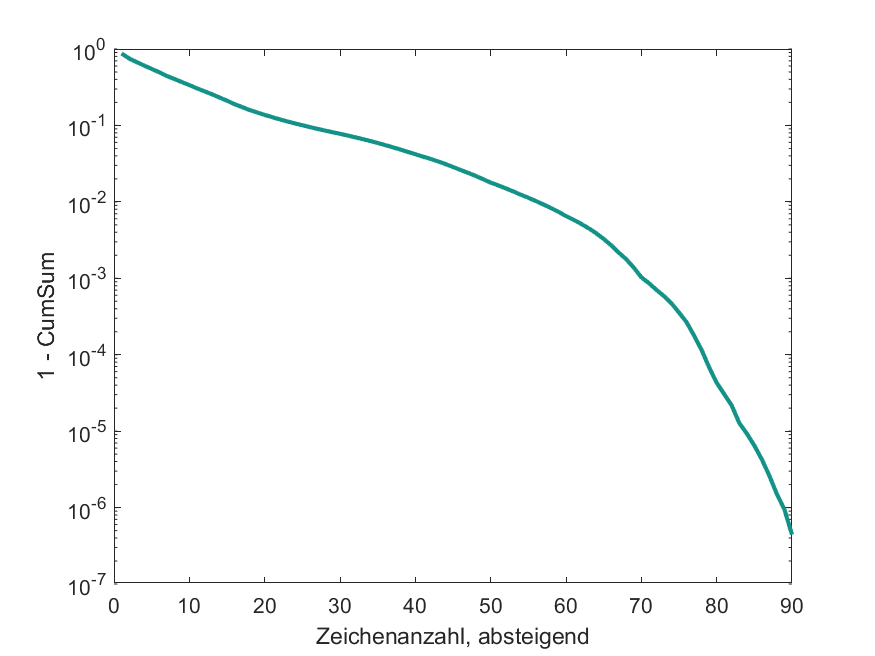
Wenn man die Zeichenanzahl kumuliert und sortiert, dann bekommt man eine Abbildung, die zeigt wie viele Zeichen man benötigt, um eine entsprechende Menge des Textes damit zu beschreiben. Wenn wir noch ein 1 - davor schreiben, dann sieht es auf dem log-Plot etwas schöner aus. Nach allem Abschneiden, Löschen und ersetzen, können wir nun mit ca. 90 Zeichen mehr als 99,99% des Textes reproduzieren. Das reicht mir.
Wortstatistiken
Ein Text ist ja nicht nur eine willkürliche Sammlung von 90 Zeichen. Oft hat die Reihenfolge dieser Zeichen eine Bedeutung. Diese Kombination von Zeichen nennt sich Worte. Also zerlegen wir den Text am Freizeichen (ich nehmen hier alle Whitespaces) und machen die selbe Analyse wie bei den Zeichen.
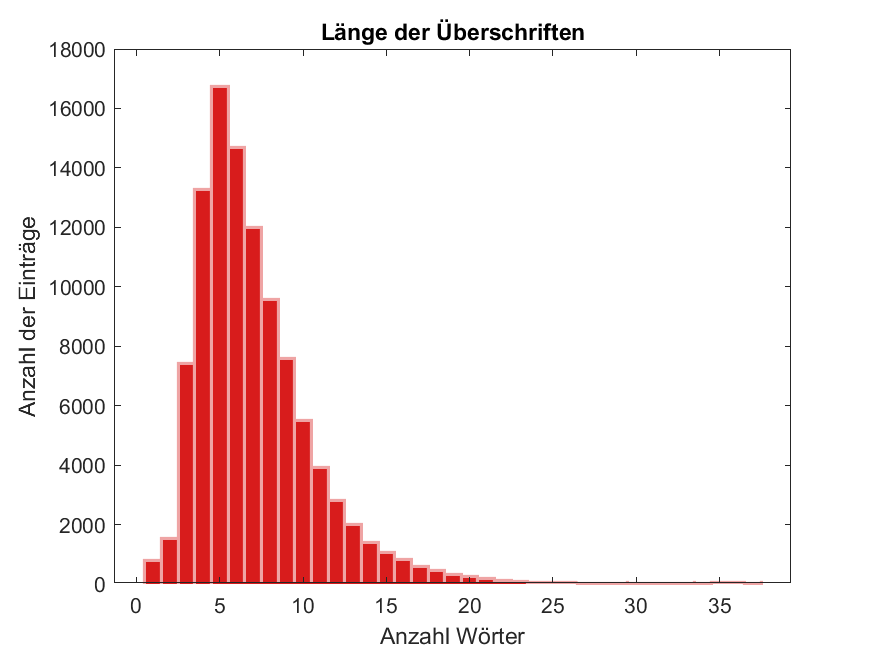
Sieht fast genau so aus, wie das Histogramm der Zeichen, außer, dass die x-Achse durch zehn geteilt ist. Trotzdem, die längste Überschrift hat 27 Worte.
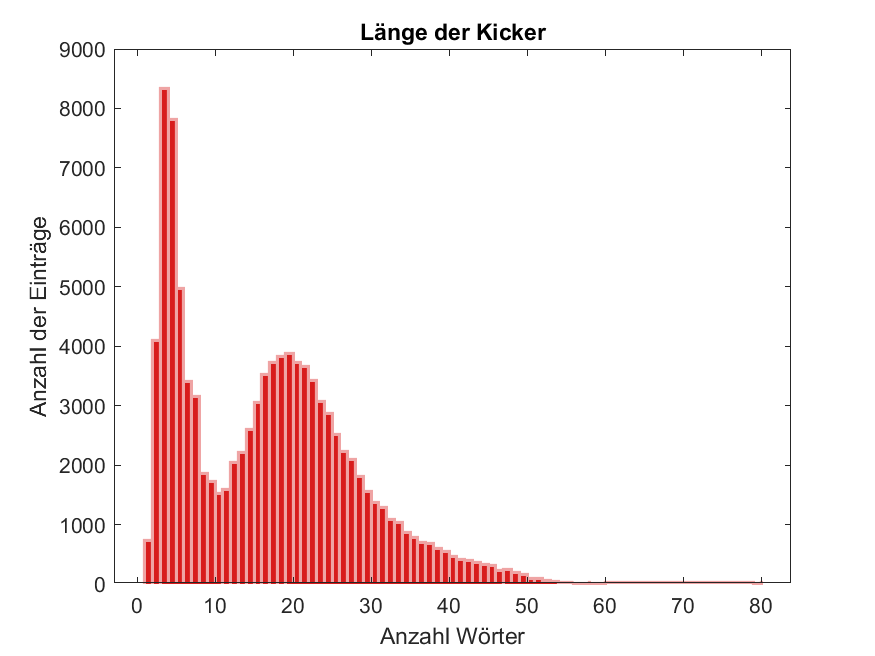
Nicht überraschend sieht auch das Histogramm des Kickers / der Zusammenfassung so aus wie das derer Zeichen. Diesmal aber dividiert durch sechs? Egal, das soll das Neuronale Netz lernen und nicht ich.
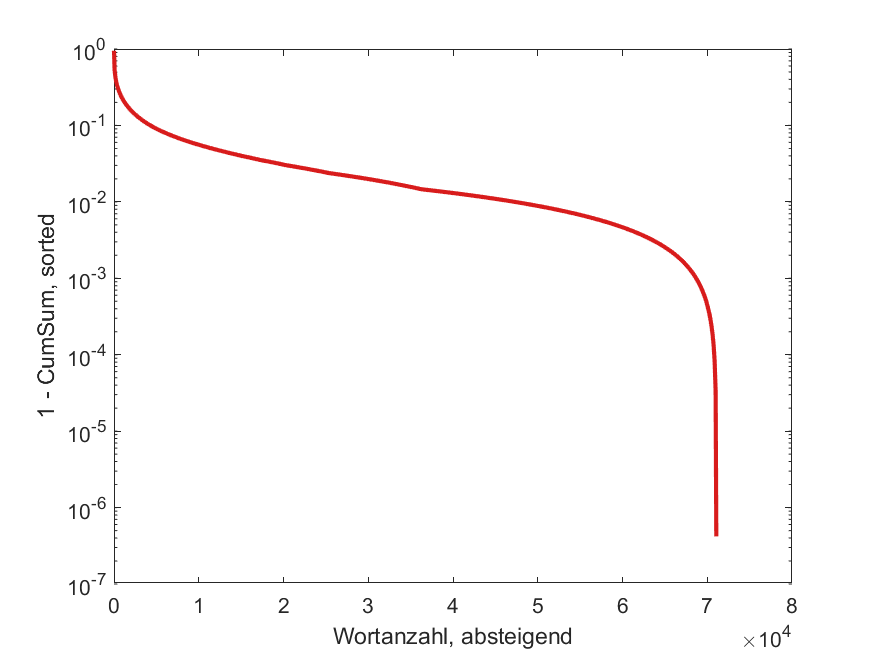
Insgesamt gibt es im Datensatz insgesamt 2 379 962 Worte und 71 068 unterschiedliche Worte
Ich habe auch mal die häufigsten Wörter herausgesucht, und das hier ist die Liste sortiert in absteigender Anzahl:
| Wort | Anzahl |
|---|---|
| in | 82240 |
| der | 81128 |
| und | 48202 |
| - | 41868 |
| Polizei | 37035 |
| auf | 34500 |
| am | 34050 |
| einem | 28385 |
| ein | 26516 |
| an | 26458 |
| die | 25379 |
| mit | 22018 |
| Uhr | 19561 |
| zu | 19423 |
| nach | 18816 |
| Am | 18369 |
| im | 17383 |
| verletzt | 17297 |
| von | 15527 |
| bei | 15077 |
| ... | ... |
| überhartes | 1 |
Was ist denn überhartes? Naja, das kommt halt so vor.
Zur Vollständigkeit hier nochmal die kumulierten Werte für Überschrift und Kicker. Von den über zwei Millionen Worten, machen 5000 etwa 90% aller Worte aus. Der Rest ist, quasi Nebensache.
Bestandszahlen
Die Datenlage, die ich hier organisiert habe ist gar nicht mal so schlecht und hat sich über die letzten 11 Jahre auch sehr schön entwickelt.
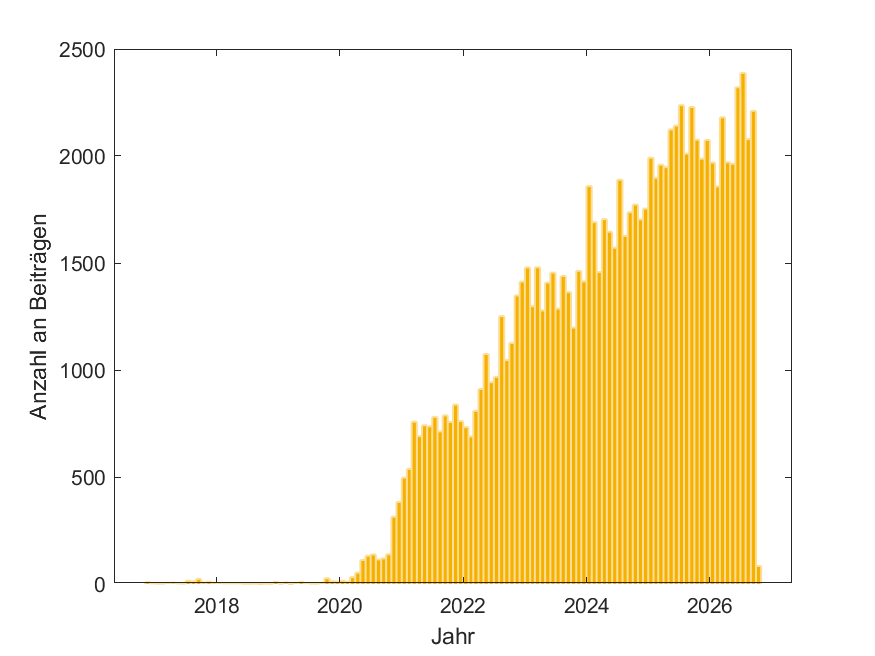
So ist die Anzahl an Beiträgen von 2020 an stetig gewachsen und hat nun 2026 die Zahl von ca. 2400 Beiträgen pro Monat erreicht. Das sind ca. 100 pro Tag. Damit kann ich arbeiten.
Großbuchstaben und Satzzeichen
Wäre ich noch auf dem richtigen SHIT-Tripp, dann wäre das noch eine schöne Messgröße. Da die Polizeimeldung eher langweilig sind, werde ich nicht auch noch diese Statistiken hier Ausbreiten. Ich hab langsam auch kein Bock mehr auf regexp und auf Histogramme.
Wie geht es weiter?
Ich lasse mich mal überraschen, wie und wann ich an dieser Baustelle weiterarbeite, denn die Datenaufbereitung war wirklich sehr scheiße, passend zum Namen dieser Serie.